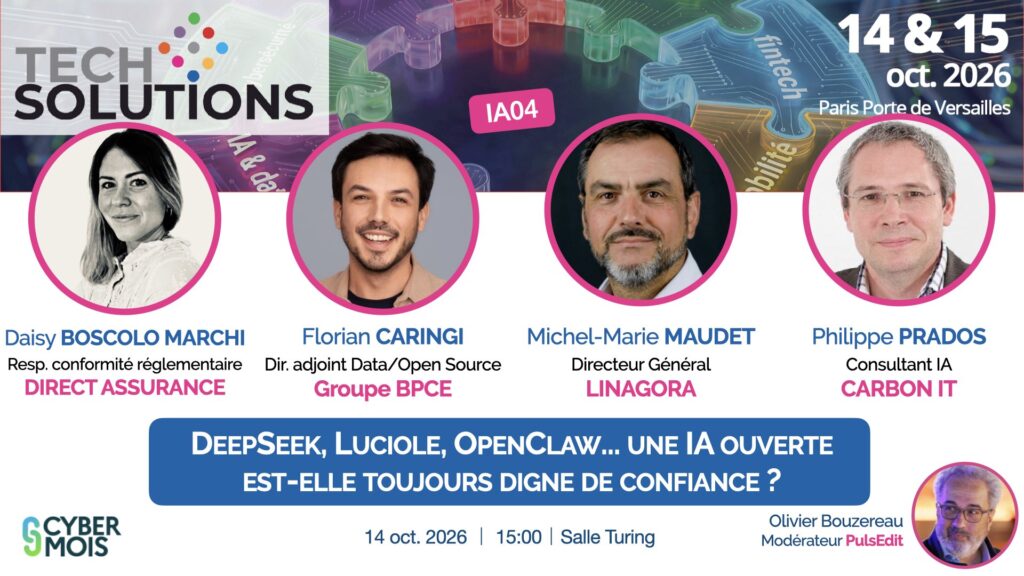
Panel de 15:00-15:45
Une IA open source est-elle toujours digne de confiance ?
Daisy BOSCOLO-MARCHI, Responsable conformité réglementaire, DIRECT ASSURANCE
Florian CARINGI, Directeur adjoint Data et Open Source, BPCE
Michel-Marie MAUDET, Directeur Général, LINAGORA
Philippe PRADOS, Consultant IA, CARBON IT
Bienvenue à tous pour ce débat qui nous interroge sur l’IA open source. Est-elle plus digne de confiance que les modèles propriétaires : plus transparente, plus auditable, plus souveraine parce qu’ouverte ? Ou un modèle ouvert mal documenté est-il aussi opaque qu’une boîte noire ? Ouvrir le code d’une interface ou les poids d’un modèle suffit-il à garantir la confiance ?
Tour de table : Daisy (conformité RGPD et AI Act, Direct Assurance), Florian (data, IA et open source, BPCE), Michel-Marie (éditeur de logiciels, LINAGORA), Philippe (consultant IA, Carbon IT).
- Michel-Marie (LINAGORA) : Avec Luciole, vous défendez une IA open source souveraine. Qu’est-ce qui rend un modèle plus digne de confiance : l’ouverture du code, des poids, des données d’entraînement, ou la gouvernance des données et le suivi des dépendances ?
- Philippe (Carbon IT) : Quelles grandes familles de modèles faut-il distinguer aujourd’hui, des LLM aux modèles de pointe ?
- Florian (BPCE) : Dans la banque, qu’apporte l’open source à la confiance des développeurs et des clients : maîtrise du code, indépendance vis-à-vis d’un fournisseur, possibilité d’auditer ? Qu’est-ce qui pèse le plus ?
- Daisy (Direct Assurance) : Une licence open source garantit-elle une vraie liberté d’usage ? Que regarde votre équipe conformité : restrictions, obligations de redistribution, conditions particulières ?
- Florian : Un modèle open source hébergé en interne limite-t-il vraiment les fuites de données par rapport à un modèle propriétaire chez un tiers ? Ou est-ce un faux sentiment de sécurité ?
- Michel-Marie : La souveraineté est devenue un critère de confiance à part entière : elle recouvre le lieu d’hébergement, l’indépendance vis-à-vis des géants américains ou chinois. Quels autres objectifs ?
- Philippe : Un agent IA peut sortir de son cadre et dérailler. Quelles précautions prendre ? Comment avoir un contrôle réel sur ce qu’il fait sur nos réseaux ?
- Daisy : Comment maîtriser ce que l’on ne contrôle pas : jeux de données, modèles dérivés, composants logiciels, hébergement ? Quelles exigences imposer aux fournisseurs ?
- Daisy : En cas d’erreur, de biais ou de non-conformité d’un modèle, qui porte réellement le risque : le fournisseur, l’intégrateur ou l’entreprise qui l’utilise ?
- Philippe : Un modèle peut se tromper ou répondre différemment d’une version à l’autre. Peut-on bâtir un service fiable dessus ? La confiance vient-elle de l’ouverture du modèle ou de l’accompagnement des utilisateurs ?
- Michel-Marie : Toute IA open source est-elle digne de confiance par défaut ? Certains projets affichant le label « ouvert » ne la méritent-ils pas ?
- Florian : Pouvez-vous nous citer un cas d’usage récent dans votre établissement ? Quels points de vigilance sur l’open source avez-vous appris à ne pas sous-estimer ?
- Philippe : Quelles sont les causes de succès / d’échec fréquentes : bon ou mauvais choix d’architecture, de modèles, compétences, gouvernance des données, processus, dépendances, coûts cachés ?
- Daisy : Un modèle ouvert peut évoluer, être copié, changer de licence. Comment garder la conformité dans la durée ? Quelles clauses et quelle gouvernance recommandez-vous ?
- Florian : Où sont les gains rapides pour les développeurs, les métiers et la relation client ? Quelles limites ne pas franchir ? Où renforcer le contrôle ?
- Michel-Marie : Qu’est-ce qui fait réussir un projet d’IA open source en entreprise ? Et qu’est-ce qui le fait échouer chez vos clients ?
- Daisy : Comment l’AI Act s’applique-t-il aux modèles ouverts ? Qu’est-ce qui change selon qu’on est fournisseur, déployeur ou intégrateur ?
- Michel-Marie : Quels sont les cas d’usage récents les plus convaincants de Luciole ou d’autres modèles ouverts ?
- Philippe : Quels premiers gains rapides pour les équipes IT et pour les métiers, open source ou non ?
- Daisy : Peut-on faire confiance à un modèle sans documentation claire sur ses biais et ses données d’entraînement ? L’exigez-vous avant de le valider ?
- A tous en conclusion : L’IA : bon serviteur, mauvais maître ? Nécessairement ouverte pour garder le ctrl ? Finalement, pour des utilisateurs augmentés ou « encouragés à la paresse » (Cedric Villani) ?
- Questions des auditeurs et remerciements.
Les intervenants seront ravis de vous répondre, dans les espaces prévus à l’extérieur. Merci à tous, très bon salon et bonne fin de journée.